Notas de la Immersion de TECD en Harvard (2): segundo día
Lo que hace falta para que un buen modelo se convierta en buena atención
Índice
Sigo con el segundo día, a continuación de la entrada anterior.
Si el primer día giró sobre todo en torno a la tecnología y a cómo se paga, el segundo se centró más en la tecnología en sí.
Hubo cuatro sesiones.
Sesión 1: aplicaciones de salud digital y software como dispositivo médico
La primera sesión la dio el profesor Stern, codirector del curso (TECD). Trató sobre las aplicaciones de salud digital y el software como dispositivo médico (SaMD, Software as a Medical Device).
Personalmente es un tema que me gusta mucho.
Ya lo toqué en parte en entradas antiguas, pero cuando se habla de salud digital las terapias digitales aparecen tarde o temprano. Lo mismo pasa con el SaMD, en el que el propio software se registra como dispositivo médico.
Ya era un tema de moda cuando empecé a interesarme por este campo siendo estudiante de medicina, así que tenía curiosidad por ver cuánto había cambiado ahora que terminé la residencia. En resumen: todavía queda mucho camino.
Tratar el software como dispositivo médico y autorizarlo trae un problema de fábrica. El software se actualiza con regularidad. Y no se puede pedir una autorización nueva con cada actualización, ¿verdad?
SaMD es el software que cumple por sí mismo una finalidad médica, sin formar parte de un dispositivo médico físico. El software integrado en un dispositivo, como el de una bomba de insulina, se llama SiMD (Software in a Medical Device). Por número de autorizaciones de la FDA, el SiMD sigue superando al SaMD.
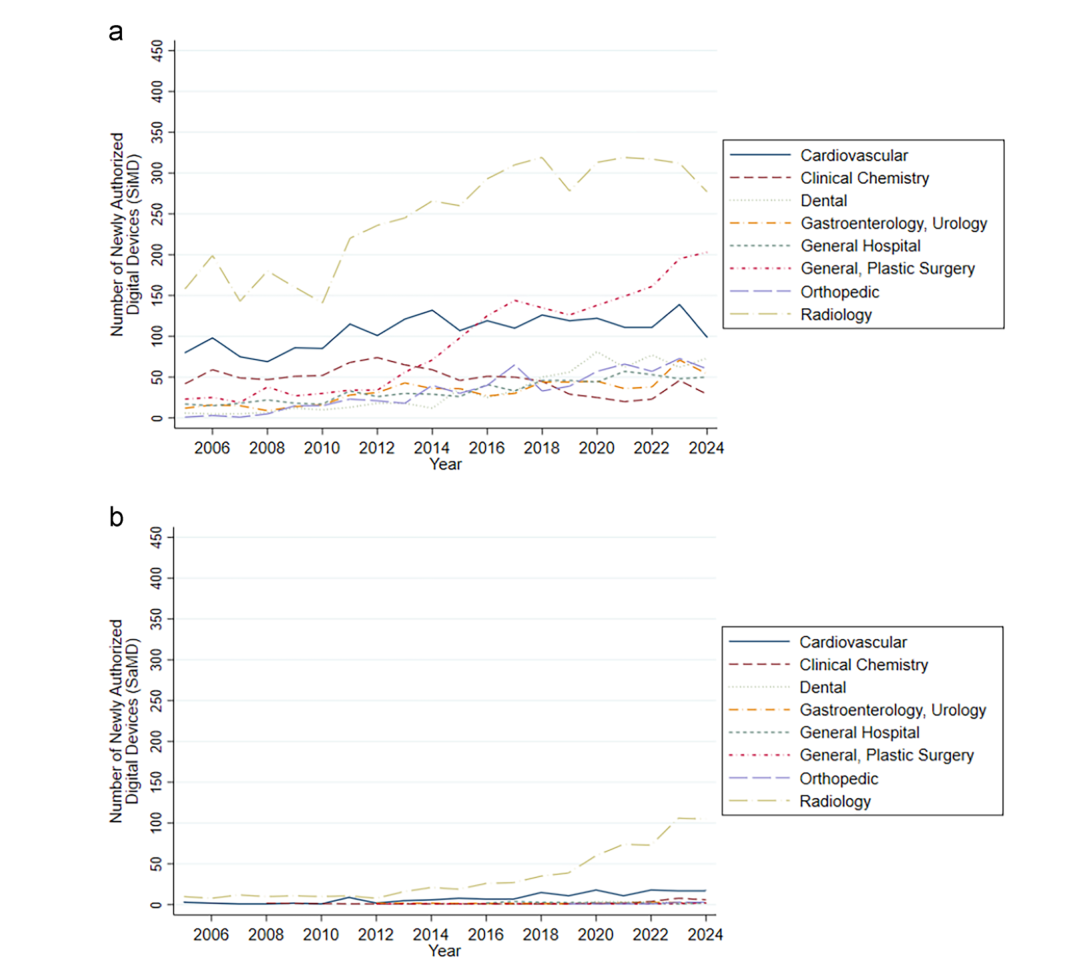
Autorizaciones anuales de la FDA de software integrado en dispositivos (SiMD, arriba) y de SaMD (abajo). Fuente: Everhart et al., npj Digital Medicine 2026, Fig. 3, CC BY 4.0.
En la clase también se señaló que el software cambia continuamente y con él puede cambiar su rendimiento, que la interrupción de un servicio puede perjudicar a los pacientes y que la primera versión de un producto dice poco sobre cómo será más adelante.
Estados Unidos ya intentó resolverlo una vez. Fue el piloto Pre-Cert de la FDA, que mencioné de pasada al final de la entrada anterior. En lugar de revisar el software versión por versión, la idea era examinar las prácticas de desarrollo de la empresa que lo fabrica y certificarla de antemano. Participaron nueve empresas, entre ellas Apple, Samsung y Fitbit, pero el piloto terminó en 2022. La conclusión fue que era difícil de aplicar con la autoridad legal que tiene hoy la FDA.
Hay otro problema tan grande como la regulación: el reembolso. Nada de esto es sostenible sin una respuesta clara a quién paga.
El ejemplo principal fue el DiGA alemán. Al parecer viene de Digitale Gesundheitsanwendung.
Es un sistema que conecta los productos de salud digital con la prescripción y el reembolso. Por lo que encontré, Alemania fue uno de los primeros países en introducir la regulación y el reembolso de las aplicaciones de salud digital, con su Ley de Salud Digital (Digital Healthcare Act) de 2019.
DiGA enlaza las aplicaciones de salud digital con la vía de prescripción y reembolso. Normalmente la evidencia clínica pesa mucho en una autorización, claro. Pero si un producto cumple los requisitos básicos, como seguridad, protección de datos e interoperabilidad, DiGA le concede una inclusión provisional aunque la evidencia de efecto todavía sea escasa. Durante ese periodo el seguro cubre la aplicación mientras la empresa reúne evidencia. Si demuestra un efecto dentro del plazo, pasa a inclusión definitiva; si no, queda fuera. (Los dispositivos de mayor riesgo, de clase IIb, no pueden optar a la inclusión provisional.)
Al dar tiempo para reunir evidencia clínica, es una orientación regulatoria favorable a las aplicaciones de salud digital.
También es interesante que el efecto que hay que demostrar no tiene por qué ser un beneficio médico como la mejoría de los síntomas. Las mejoras en la estructura o el proceso de la atención, como una mejor adherencia o un mejor acceso, también cuentan.
Si se miran por área las sesenta y tantas aplicaciones incluidas, 30 son de salud mental, 8 de aparato locomotor y 5 de endocrinología, así que por ahora la lista se inclina mucho hacia los trastornos psiquiátricos.
Otro punto que me pareció interesante: al evaluar una terapia digital hay que distinguir el contenido completo de la aplicación (full dose), la parte que el paciente realmente abrió (consumed dose) y la parte que llevó a un cambio real de conducta (realized dose).
Sesión 2: la transformación digital de la patología y Test → Process → Service
Esta sesión trató sobre la transformación digital de la patología.
El ponente fue el Dr. Jochen Lennerz, director médico en Natera.
Natera es una empresa estadounidense de diagnóstico conocida por sus pruebas que analizan el ADN libre circulante en sangre. Las más conocidas son las de cribado prenatal (Panorama), enfermedad residual molecular en cáncer (Signatera) y rechazo de trasplantes (Prospera).
Dijo que estas son las preguntas que hay que hacerse ante una tecnología diagnóstica.
- ¿Mide con exactitud? (analytical validity)
- ¿Lo que mide está relacionado con la enfermedad real? (clinical validity)
- ¿Beneficia al paciente? (clinical utility)
- ¿Puede la institución mantenerla en funcionamiento? (business value)
Preguntas de ese tipo.
Superar un paso no garantiza el siguiente. Que un algoritmo detecte bien el cáncer no asegura mejores decisiones de tratamiento ni mejor pronóstico.
La expresión que se me quedó grabada fue Test → Process → Service.
- Test: ¿la prueba o el algoritmo da el resultado correcto?
- Process: ¿funcionan de verdad el manejo de la muestra, el informe, la entrega y la revisión?
- Service: ¿el paciente llega a recibir la siguiente prueba o el tratamiento?
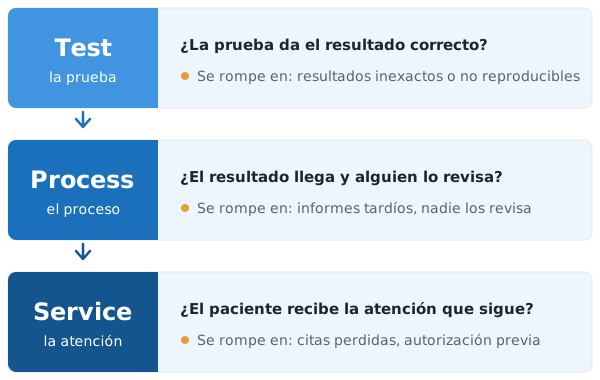
Diagrama propio, basado en la clase y en el Diagnostic Quality Model de Lennerz et al. (Clin Chem Lab Med, 2023).
¿De qué sirve una prueba exacta? Solo tiene sentido cuando se refleja en la atención.
Aunque el resultado sea bueno, todo termina ahí si el responsable no llega a verlo, si el paciente no acude a la siguiente consulta o si el tratamiento se retrasa por la autorización previa del seguro.
La segunda mitad de la clase fue sobre regulación.
Dijo que la tecnología, la clínica y la regulación avanzan a velocidades distintas, y presentó dos enfoques para manejar con seguridad productos que cambian continuamente.
Uno es el PCCP (Predetermined Change Control Plan), en el que se decide de antemano hasta dónde puede cambiar el producto y cómo se validará cada cambio. El otro es el shadow deployment, en el que la herramienta funciona en paralelo sobre los mismos casos sin influir en la atención real y se comparan los resultados. (Por supuesto, que funcione bien en modo shadow no demuestra un beneficio clínico.)
Hubo cierto solapamiento con el last mile problem del primer día.
Sesión 3: si la IA mejora, ¿aprendemos menos?
La tercera sesión también la dio el profesor Stern.
Fue un caso sobre Aidoc, una empresa de IA para radiología. En lugar de fijarnos solo en el rendimiento diagnóstico del modelo, miramos el conjunto: cuánto se integró el producto en el flujo de trabajo, cómo se distribuyó, cómo eran sus relaciones con los clientes y cómo manejó la regulación.
Hubo dos ideas centrales.
- La innovación ocurre cuando las barreras regulatorias y de modelo de negocio son bajas.
- La adopción solo tiene éxito cuando la innovación encaja en los modelos de pago y los flujos de trabajo existentes.
Obvio, pero importante.
Aidoc se presentó como una empresa que acertó en ambas. Es la que tiene más algoritmos autorizados por la FDA, su equipo pasó mucho tiempo en hospitales desde el principio, y primero vendió a los servicios de radiología antes de ampliar sus ventas a la dirección de los hospitales.
Me llamó la atención una frase del director ejecutivo: la IA nunca trató de la IA en sí, sino de cambiar procesos para ayudar a las personas. Estoy de acuerdo.
También se debatió si la empresa debía desarrollar más modelos propios o convertirse en una plataforma que ofreciera además algoritmos de otras empresas. Si gestionas una plataforma y además vendes en ella tus propios productos, acabas compitiendo con las empresas que entraron en ella. Recuerda a lo que hablamos el primer día sobre Epic y los proveedores de ambient scribe.
Después la conversación pasó a cómo afectará la IA a las competencias básicas de los médicos. Discutimos escenarios de upskilling, en el que la IA te hace mejor, deskilling, en el que se pierden habilidades existentes, y never-skilling, en el que lo básico nunca llega a aprenderse.
Sinceramente, ¿no es inevitable que cuanto más trabajo le dejemos a la IA, menos habilidad desarrollemos en algunas áreas? Nadie da un rodeo cuando hay un camino más fácil. En mi equipo hay un debate abierto sobre cuánto uso de la IA deberíamos permitir a los residentes en formación, y esto tiene que ver con ello. Aprender a hacer bien el trabajo y luego usar la IA para facilitarlo no es lo mismo que depender de ella desde el principio sin haber pasado por eso.
Sesión 4: AI Prompt-a-thon
La última sesión fue un taller práctico de prompts.
Probamos varias técnicas, entre ellas el reverse prompting, en el que primero explicas lo que quieres hacer y le pides a la IA que escriba el prompt para esa tarea.
El marco básico fue R-T-F: definir el rol (Role), la tarea (Task) y el formato de salida (Format).
Ya había trasteado con prompts antes, así que el contenido me resultó familiar. También noté lo que ha cambiado desde entonces. Antes dedicaba mucho esfuerzo a estructurar las instrucciones con detalle en formatos como Markdown o HTML, pero los modelos que uso ahora suelen entender la intención sin eso.
Aun así, asignar un rol, describir el resultado y las condiciones que quieres, y preguntarle al modelo qué más deberías considerar siguieron siendo útiles.
También nos dijeron que hay que evaluar la respuesta, no el prompt. ¿Se puede comprobar la evidencia, resuelve el problema real, qué falta, la perspectiva de quién falta, y puede el lector actuar con ella?
El tercer día seguirá en la próxima entrada.
Comentarios
0Configuración del perfil
Inicia sesión para dejar un comentario.
환영합니다!
댓글에 사용할 닉네임을 설정해주세요.